Testdaten hart im Code zu verdrahten ist bequem – aber spätestens wenn man mehrere Nutzer, Varianten oder Umgebungen testen will, wird es unübersichtlich. Eine einfache und weit verbreitete Lösung: Die Testdaten liegen in einer CSV-Datei und werden zur Laufzeit eingelesen.
In diesem Beitrag zeige ich, wie man mit Playwright und dem npm-Paket csv-parse Daten aus einer CSV-Datei liest, in strukturierte Objekte umwandelt und für parametrisierte Tests nutzt – inklusive KI-Unterstützung, um daraus schnell mehrere Testfälle zu generieren. Seid gespannt! 🙂
Kurz: Worum geht es in diesem Beitrag?
Wir gehen folgende Schritte durch:
Eine CSV-Datei mit Testdaten anlegen.
Die Datei per Playwright-Test einlesen und in JS-Objekte umwandeln.
Aus den Daten mehrere parametrisierte Tests generieren.
KI als Unterstützung nutzen, um Testfälle und Selektoren aus den CSV-Daten und dem echten HTML abzuleiten.
Für das Einlesen nutzen wir das npm-Paket csv-parse.
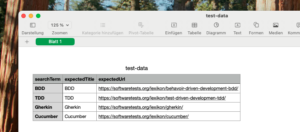
Zuerst legen wir unter data/test-data.csv eine kleine Datei mit Testdaten an.
Als Beispiel nutze ich die Volltextsuche im Lexikon meiner Seite: Für jeden Suchbegriff soll geprüft werden, ob der erwartete Beitrag als Ergebnis erscheint.
Hinweis: Sensible Daten gehören nicht in die CSV. Landet die Datei in einem öffentlichen Repository, sollten dort natürlich ausschließlich unkritische Testdaten stehen. 🙂 Für Zugangsdaten oder andere sensible Werte eignet sich eine CSV natürlich grundsätzlich schlecht – hierfür besser Umgebungsvariablen oder einen Secrets-Manager verwenden.
Installation: csv-parse einbinden
Ich gehe davon aus, dass bereits ein Playwright-Projekt existiert. Falls nicht, lässt sich eines mit npm init playwright@latest anlegen.
Die Installation von csv-parse ist mit einem einzigen Befehl im Projektverzeichnis erledigt:
npm install csv-parse --save-dev
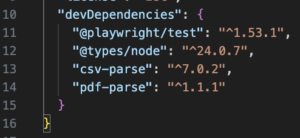
Damit wird das Paket automatisch in die package.json eingetragen.
Anschließend wird die synchrone Parse-Funktion im Test importiert:
import { parse } from 'csv-parse/sync';
CSV-Inhalt auslesen
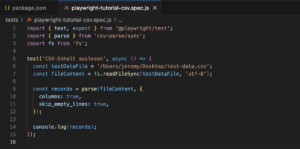
Der erste Test dafür ist schnell aufgesetzt: Wir lesen die Datei über fs.readFileSync als Text ein und übergeben den Inhalt an csv-parse. Mit der Option columns: true werden die Spaltenüberschriften automatisch als Objekt-Keys verwendet.
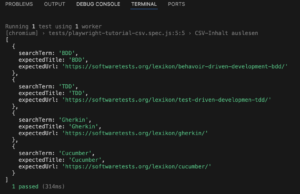
Führt man den Test aus, wird ein Array mit einem Objekt pro CSV-Zeile in der Konsole ausgegeben – z. B.
Damit ist das Auslesen erledigt – die halbe Miete ist geschafft.
Präzise validieren: KI zur Unterstützung nutzen
Sobald die CSV-Daten als Objekte vorliegen, stellt sich die Frage: Wie leitet man daraus sinnvolle Testfälle und Prüfungen ab, ohne für jede Zeile manuell Code zu schreiben? Genau hier kann ein KI-Tool wie GitHub Copilot, ChatGPT oder Cursor gut unterstützen – etwa auf zwei Arten:
1. Testfälle aus der CSV-Struktur generieren lassen
Man kann der KI die CSV-Kopfzeile bzw. ein paar Beispielzeilen zeigen und sie bitten, daraus einen parametrisierten Playwright-Test zu erzeugen. Ein Prompt könnte etwa so aussehen:
Ich habe eine CSV mit den Spalten searchTerm, expectedTitle, expectedUrl.
Erstelle einen parametrisierten Playwright-Test in JavaScript,
der für jeden Suchbegriff die Website-Suche aufruft und prüft,
dass ein Suchergebnis mit dem erwarteten Titel und Link erscheint.
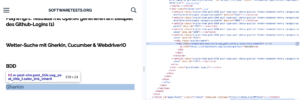
2. Selektoren aus echtem HTML ableiten lassen
Genau wie sich mit KI reguläre Ausdrücke für PDF-Inhalte erzeugen lassen, funktioniert das auch für CSS- bzw. Playwright-Selektoren: Man kopiert einen Ausschnitt des HTML-Markups der Suchergebnisseite in den Chat und lässt sich einen robusten Selektor vorschlagen.
Ein Prompt dafür könnte sein:
Hier ist ein Ausschnitt aus meiner Suchergebnisliste:
<article class="w-grid-item">
  <h2 class="post_title"><a href="/lexikon/gherkin/">Gherkin</a></h2>
</article>
Erstelle einen Playwright-Selektor, der den Link mit einem bestimmten
Linktext innerhalb der Ergebnisliste findet.
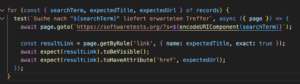
Ich benutze an dieser Stelle als Unterstützung Claude.ai und erhalte daraufhin folgenden Test:
Mehrere Datensätze durchtesten
Der eigentliche Mehrwert der CSV-Daten zeigt sich, wenn man mit einer Schleife über records automatisch mehrere Testfälle generiert, ganz ohne den Testcode zu duplizieren. In diesem Beispiel rufe ich für jeden Suchbegriff die Suchergebnisseite von softwaretests.org auf und prüfe, ob ein Link mit dem erwarteten Titel und der erwarteten URL erscheint:
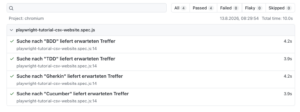
So entsteht pro CSV-Zeile automatisch ein eigener, benannter Testfall – bei vier Zeilen in der CSV also vier Tests, die jeweils prüfen, ob die Suche den richtigen Lexikon-Beitrag findet.
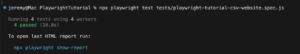
Dies hat offenbar gut funktioniert:
Ich werfe noch einen Blick in den Reporter:
Hinweis: Warum exact: true wichtig ist
Die Suchergebnisse enthalten oft mehr als nur exakte Treffer – bei “BDD” liefert die Suche z. B. auch verwandte Artikel wie Jira- oder Gherkin-Beiträge mit, in denen der Begriff nur erwähnt wird.
Ohne exact: true könnte Playwright versehentlich einen falschen Link matchen, dessen Text den Suchbegriff nur als Teilstring enthält.
Da jedes Suchergebnis auf softwaretests.org als normaler <a>-Link mit dem Beitragstitel als Text ausgegeben wird, funktioniert getByRole('link', { name: expectedTitle, exact: true }) hier zuverlässig.
Tipps für bessere Ergebnisse
1. exact: true bei Linktexten nutzen: Verhindert, dass z. B. “BDD” auch einen Treffer wie “BDD-Grundlagen” fälschlich matcht.
2. KI für Testgenerierung & Selektoren nutzen: Aus einer CSV-Struktur und echtem HTML-Markup lassen sich mit KI-Unterstützung schnell parametrisierte Tests und passende Selektoren ableiten.
3. Schleifen statt Kopieren: Mit einer Schleife über die Records lassen sich beliebig viele Suchbegriffe aus einer einzigen CSV-Datei durchtesten.
4. Erwartete URL mitprüfen: Neben dem Linktext auch das href-Attribut zu prüfen stellt sicher, dass wirklich der richtige Beitrag verlinkt ist – nicht nur ein Treffer mit ähnlichem Titel.
Fazit: Einfacher als gedacht
Die Eingangsfrage war: Lässt sich das Testen mit CSV-basierten Testdaten in Playwright wirklich einfach automatisieren?
Meine Antwort: Ja. :- ) Mit csv-parse, ein paar Zeilen Code und KI-generierten Testfällen bzw. Selektoren lassen sich beliebig viele Suchbegriffe aus einer einfachen CSV-Datei in die eigene Playwright-Testsuite integrieren – ganz ohne unnötigen Aufwand.